
בקרת איכות מוקד cAI
בקרת איכות מוקד עם AI — לא מדגם, ולא מספרים מומצאים
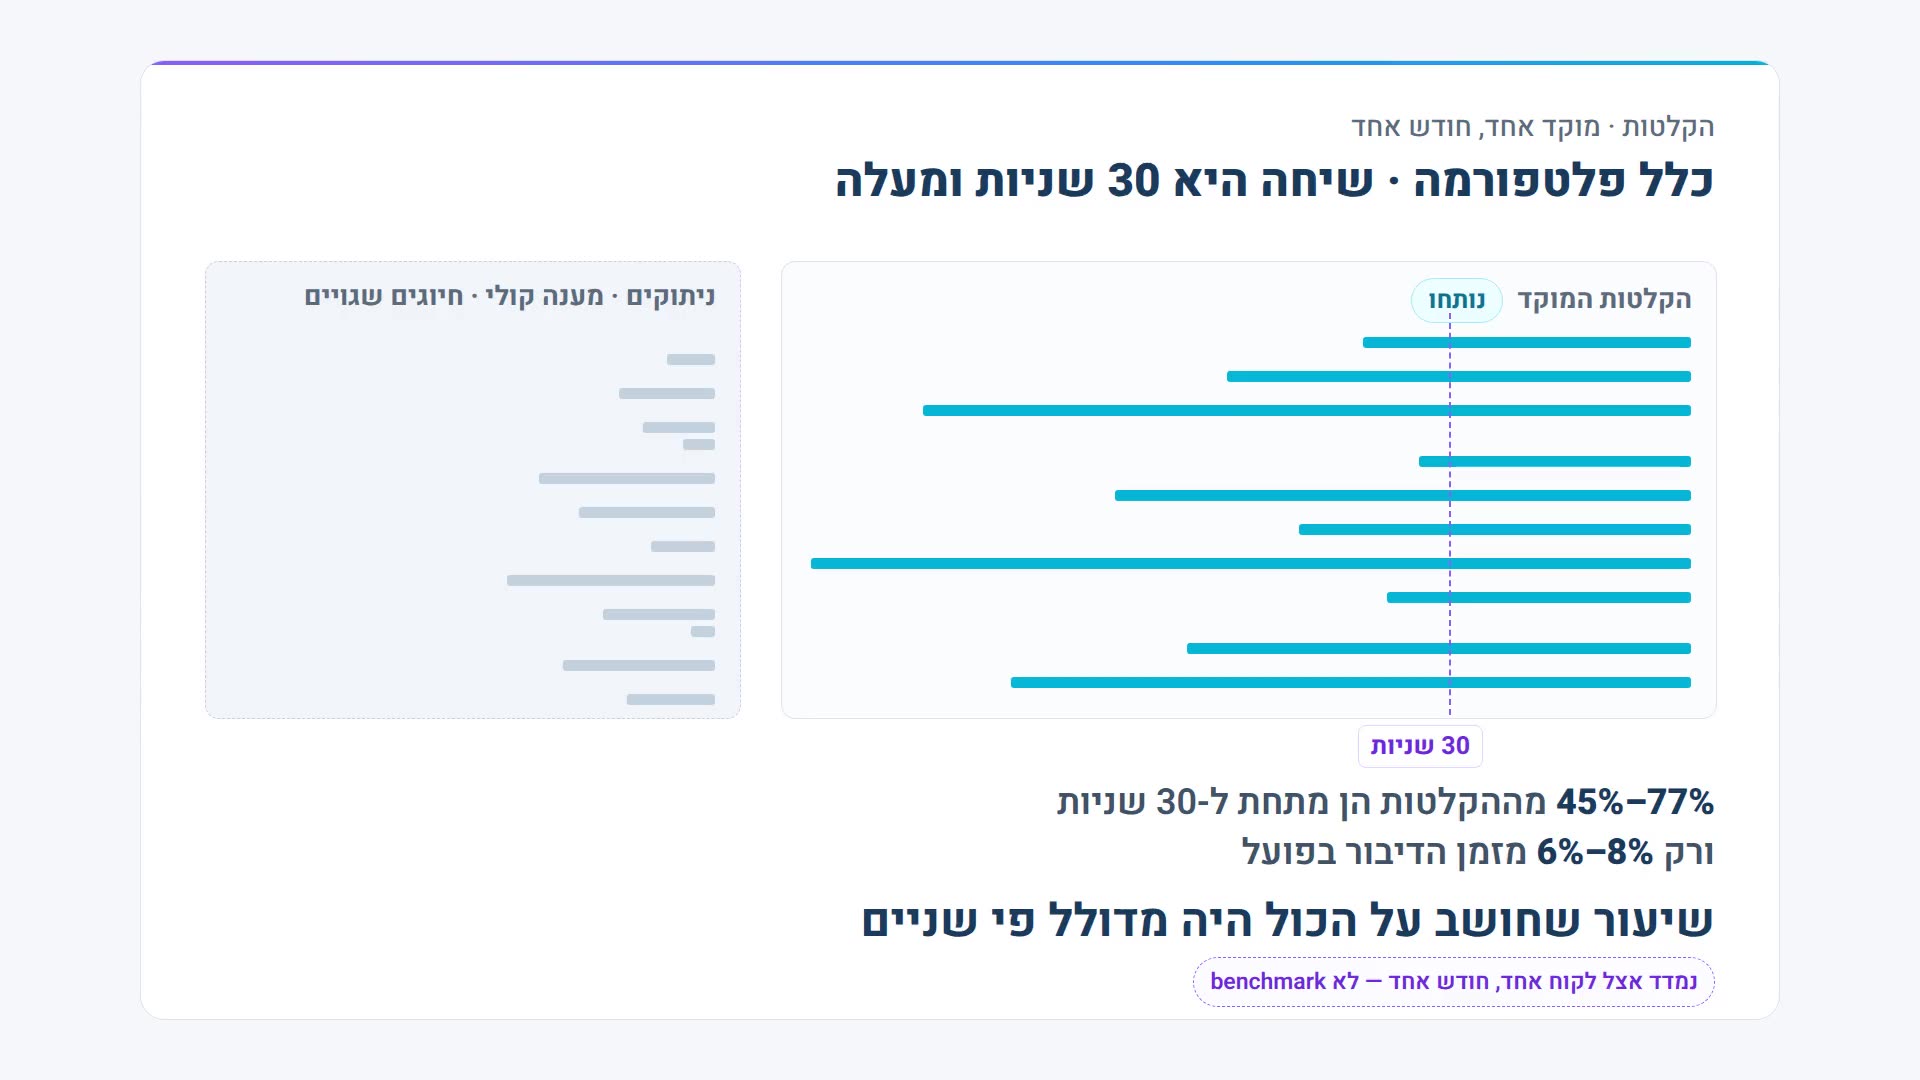
cAI בודק כל שיחה של 30 שניות ומעלה בשלוחות שבחרתם — לא מדגם של שתי שיחות בשבוע לנציג. מכל שיחה נבדקות שבע שאלות איכות ושישה דגלי סיכון. וכל שיעור מוצג רק כשיש מאחוריו 150 שיחות; מתחת לזה נכתב ״אין מספיק נתונים״, עם ספירה כמה חסרות — ולא מספר.
עודכן:
- עברית מהיסוד
- רק מה שבחרתם
- ישר עם המספרים
בקרת איכות שיחות במוקד, בעברית. הבדיקה נעשית על שיחות טלפון, וואטסאפ ומייל.
מה נבדק בכל שיחה
שתי רשימות סגורות, זהות לכל הלקוחות. הן לא נגזרות מתסריט השיחה שלכם — ולכן אפשר להשוות בין תקופות, בין שלוחות, ובין ענפים.
שבע שאלות איכות
- הזדהות
- אמפתיה
- צעד הבא ברור
- אישור הלקוח
- ועוד שלוש
שישה דגלי סיכון
- התחייבות ללא מועד
- בקשת הסלמה
- סיכון נטישה
- מידע בעל רגישות מיוחדת
- אזכור מתחרה
- ועוד אחד
השאלות והדגלים הם 13 מתוך 56 השדות שנגזרים מכל שיחה. השאר: סיווג ותוצאה, נושא, סנטימנט בפתיחה ובסיום, התחייבויות הנציג, משימות המשך, ו-19 מדדי שיחה מחושבים.
אין ״אחוז הצלחה״ אחד למוקד
הצלחה אומרת דבר שונה בכל סוג שיחה. שיחת מכירה שנגמרת ״נפתר״ היא סגירה; שיחת תיאום שנגמרת ״נפתר״ היא קביעת תור. אותה מילה, שני עסקים. לכן cAI מחשב הגדרת הצלחה לכל סוג בנפרד, וכל שורה עומדת בפני עצמה.
| סוג שיחה | שיחות בתקופה | הצלחה — טווח בין הנציגים | מסקנה |
|---|---|---|---|
| שיחת שירות | 1,140 | 64%–91% | מפריד — יש מה לאמן |
| ליד חדש | 402 | 75%–92% | מפריד |
| שיחת מכירה | 318 | 4%–17% | שטוח — אין מה לאמן |
| תלונה | 66 | אין מספיק נתונים חסרות 84 שיחות ל־150 | נספר בנפח; לא נגזר ממנו שיעור |
שיחת שירות
- שיחות בתקופה:
- 1,140
- הצלחה — טווח בין הנציגים:
- 64%–91%
- מסקנה:
- מפריד — יש מה לאמן
ליד חדש
- שיחות בתקופה:
- 402
- הצלחה — טווח בין הנציגים:
- 75%–92%
- מסקנה:
- מפריד
שיחת מכירה
- שיחות בתקופה:
- 318
- הצלחה — טווח בין הנציגים:
- 4%–17%
- מסקנה:
- שטוח — אין מה לאמן
תלונה
- שיחות בתקופה:
- 66
- הצלחה — טווח בין הנציגים:
אין מספיק נתונים
חסרות 84 שיחות ל־150
- מסקנה:
- נספר בנפח; לא נגזר ממנו שיעור
כל המספרים בטבלה נמדדו אצל לקוח אחד, חודש אחד — לא benchmark ענפי.
נמדד אצל לקוח אחד, חודש אחד — לא benchmark ענפי
שימו לב לשורה שאיננה כאן: כל השיחות יחד. שם הפיזור בין הנציגים הוא 3%–88% באותו מוקד שנמדד — וזה אפקט תמהיל, לא פער בין אנשים. מערכת שמשווה נציגים על פני סוגים מדרגת את מי שקיבל שיחות שירות מעל מי שקיבל שיחות מכירה, ולא אומרת דבר על איכות.
למה הסף הוא 150 שיחות
שיעור צריך מכנה. בלי מכנה מספיק גדול, המספר זז מיום ליום על רעש — ומנהל שמגיב לתזוזה כזאת מגיב לכלום.
| מוקד | שיחות ליום | תנודה יומית | מה זה אומר |
|---|---|---|---|
| גדול | 1,221 | 0.5 נקודות | תזוזה של 2 נקודות היא סיגנל אמיתי |
| קטן | 178 | 6.7 נקודות | נע בין 0% ל-33% על רעש בלבד |
מוקד גדול
- שיחות ליום:
- 1,221
- תנודה יומית:
- 0.5 נקודות
- מה זה אומר:
- תזוזה של 2 נקודות היא סיגנל אמיתי
מוקד קטן
- שיחות ליום:
- 178
- תנודה יומית:
- 6.7 נקודות
- מה זה אומר:
- נע בין 0% ל-33% על רעש בלבד
שני המוקדים נמדדו אצל לקוח אחד, חודש אחד — לא benchmark ענפי.
נמדד אצל לקוח אחד, חודש אחד — לא benchmark ענפי
150 היא הנקודה שבה שיעור של 10% נמדד לדיוק של ±5 נקודות ברמת ביטחון 95%. מתחת לזה cAI כותב ״אין מספיק נתונים״ ומראה כמה שיחות חסרות עד הסף. התראה יומית במוקד הקטן הייתה זועקת פעמיים בשבוע — ומאבדת אמון תוך חודש.
מאיפה מגיע המספר 150, ולמה מתחתיו שיעור הוא רעש — באקדמיה: 150 שיחות: מאיפה מגיע הסף שמתחתיו מספר הופך לרעש.
כשכל הצוות חורג — זה נוהל, לא אדם
במוקד אחד שנמדד, ״בדיקת פתרון״ יצאה 0% אצל כל תשעת הנציגים. זה לא תשעה נציגים חלשים; זה סעיף שאינו בתסריט השיחה. הממצא עלה למנהל כשורה אחת, ואף נציג לא קיבל עליו כרטיס משוב.
על כל ממצא לנציג עוברים שני שערים: (1) הנציג חורג, וגם (2) הנציגים בכלל נבדלים במדד הזה.
בלי השער השני, כל תקלת נוהל מתורגמת לתשע התראות אישיות — וזה בדיוק מה שהופך דוח איכות למסמך שאף אחד לא פותח.
נמדד אצל לקוח אחד, חודש אחד — לא benchmark ענפי
בקרת איכות ידנית מול cAI
לפי McKinsey (2024), בקרת איכות ידנית מכסה פחות מ-5% מהשיחות במוקד. ההבדל הוא לא רק בכיסוי.
בקרת איכות ידנית
- מכסה פחות מ-5% מהשיחות
- המדגם נבחר בידי אדם, ולא תמיד באקראי
- מעריכים שונים נותנים תוצאות שונות — ולכן COPC דורש כיול ביניהם[2]
- תוצר: טופס נקודתי על שיחה בודדת
cAI
- כל שיחה של 30 שניות ומעלה בשלוחות שבחרתם
- אותה שיחה, שוב, מחזירה את אותה תשובה — הרצה דטרמיניסטית
- 96% עקביות עצמית בסיווג סוג השיחה
- תוצר: שיעור לכל סוג, עם הטווח שלו, ורשימת עבודה למנהל
COPC דורש שמעריכים שונים יבדקו את אותה שיחה בנפרד וישוו. כאן המעריך אחד ואוטומטי, ולכן הכיול נעשה אחרת: אותה שיחה מורצת שוב, וההפרש בין ההרצות הוא רצפת הרעש שכל השוואה חייבת לעבור.
ארבעה דברים ש-cAI מסרב להציג
כל מוצר מציג מספרים. השאלה היא אילו מספרים הוא לא מציג — ולמה זה מה שמאפשר לפעול על השאר.
- 1
שיעור על פחות מ-150 שיחות. במקומו: ״אין מספיק נתונים״ וספירת החסר.
- 2
תווית לנציג כשהטווחים חופפים. במקומו: ״בתוך טווח הצוות״, עם שני הטווחים על אותו סרגל.
- 3
ממצא שנובע מההגדרה. ״שיחות שהלקוח אישר מצליחות יותר״ נפסל, כי האישור הוא חלק מהגדרת ההצלחה.
- 4
גילוי חריגות על פחות מ-28 יום. מתחת לזה המודול מחזיר ריק, ואומר למה.
זו הסיבה שמנהל יכול לפעול על ממצא של cAI: אם הוא מוצג, הוא עבר את הספים.
שאלות נפוצות
איך עושים בקרת איכות לכל השיחות במוקד?
בקרת איכות אוטומטית עובדת על ההקלטות שכבר קיימות: כל שיחה של 30 שניות ומעלה בשלוחות שבחרתם מתומללת, מסווגת לסוג, ונבדקת מול שבע שאלות איכות ושישה דגלי סיכון. התוצאה אינה מספר אחד למוקד אלא שיעור לכל סוג שיחה בנפרד, עם הטווח שבו המספר כנראה נמצא. הקלטות קצרות מ-30 שניות — ניתוקים, מענה קולי, חיוגים שגויים — לא נספרות, כי הן לא היו שיחה.
מכמה שיחות אפשר להסיק מסקנות?
מ-150 שיחות בכל דלי. זו הנקודה שבה שיעור של 10% נמדד לדיוק של ±5 נקודות ברמת ביטחון 95%. מתחת לסף cAI כותב ״אין מספיק נתונים״ ומראה כמה שיחות חסרות. לנציג בסוג שיחה מסוים הסף נמוך יותר — 20 שיחות — ומתחתיו מוצגות ספירות בלבד, לעולם לא שיעור. הנציג נראה בדוח; פשוט בלי אחוז שאי אפשר לעמוד מאחוריו.
למה אין אחוז הצלחה אחד למוקד?
כי הצלחה אומרת דבר שונה בכל סוג שיחה: סגירה במכירה, קביעת תור בתיאום, פתרון בשירות. במוקד אחד שנמדד, פיזור ההצלחה בין הנציגים על כל השיחות יחד היה 3%–88% — אפקט תמהיל, לא פער בין אנשים. אותו מוקד, בתוך שיחות שירות בלבד: 64%–91%. ההשוואה תקפה רק בתוך סוג, ולכן cAI מחשב אותה כך.
האם AI יכול להחליף בקר איכות?
לא במלואו, וגם לא צריך. cAI עושה את מה שאדם לא יכול: עובר על כל השיחות בשלוחות שבחרתם, מחזיר את אותה תשובה בכל הרצה, ומצביע על מה שדורש טיפול. מה שנשאר לאדם הוא ההחלטה — האם זו תקלת נוהל או פער של נציג, ומה עושים איתה בישיבת הבוקר. הדוח מכוון לשיחה הזאת, לא במקומה.
איך מודדים איכות שיחות במוקד?
מודדים בשלוש שכבות. הראשונה היא ספירה מהתמליל — יחס דיבור, מונולוג, הפרעות, אוויר מת — שהיא זהה בכל הרצה. השנייה היא שבע שאלות איכות ושישה דגלי סיכון לכל שיחה. השלישית היא הצלבה: שיעור לכל סוג שיחה, מול חציון הצוות, עם הטווח של שניהם. אם הטווחים חופפים, נכתב ״בתוך טווח הצוות״ — כלומר אין הבחנה מובהקת.
עוד באשכול: cAI — ניתוח שיחות מוקד עם AI · כרטיס המשוב לנציג · דוח לדוגמה
רוצים לראות את הבקרה על השיחות שלכם?
בהדגמה נראה איך נראית בקרת איכות על כל השיחות שלכם ולא על מדגם, מה נכנס למכנה ומה נשאר בחוץ.